En un Mac Studio M4 Max con 64 GB, Qwen3.8-27B con MTP no sustituye al modelo de mezcla de expertos de 35B que ya uso. Medido el 12 de octubre de 2026 con oMLX 0.7.0, Qwen generó 55 tokens por segundo frente a 90, y tardó 3,46 segundos en producir su primer token con un prompt de 800 tokens frente a 0,49. En una prueba de revisión de código los dos detectaron los mismos fallos con el razonamiento desactivado, y Qwen detectó menos con él activado.
El número que decide es el tiempo hasta el primer token
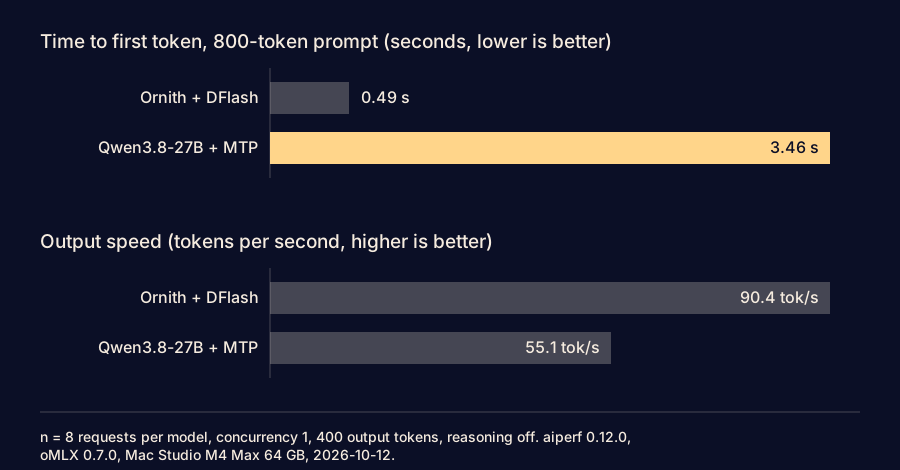
Qwen3.8-27B tarda siete veces más que Ornith 1.5 en empezar a responder a un prompt de 800 tokens: 3,46 segundos frente a 0,49, de media sobre 8 peticiones por modelo. La velocidad de salida está más cerca, 55,1 tokens por segundo frente a 90,4. En un chat esa diferencia es una molestia. Un agente de programación o una revisión de código envían prompts largos muchas veces seguidas, y ahí la espera antes del primer token es la mayor parte del coste.
oMLX es un servidor de inferencia para Macs con Apple Silicon que sirve modelos MLX detrás de una API compatible con OpenAI. Ejecuto los dos modelos en él, y cada uno tiene su propio truco para generar más rápido.
Qwen3.8-27B es un modelo denso: sus 27.000 millones de parámetros trabajan en cada token. Incluye MTP, multi-token prediction, una cabeza extra entrenada con el modelo que redacta los siguientes tokens para que el modelo los verifique de una sola pasada. Ornith 1.5 35B-A3B es una mezcla de expertos: 35.000 millones de parámetros, unos 3.000 millones activos por token. Lo ejecuto con DFlash, donde un modelo borrador pequeño y aparte propone un bloque de tokens y el modelo principal los comprueba.
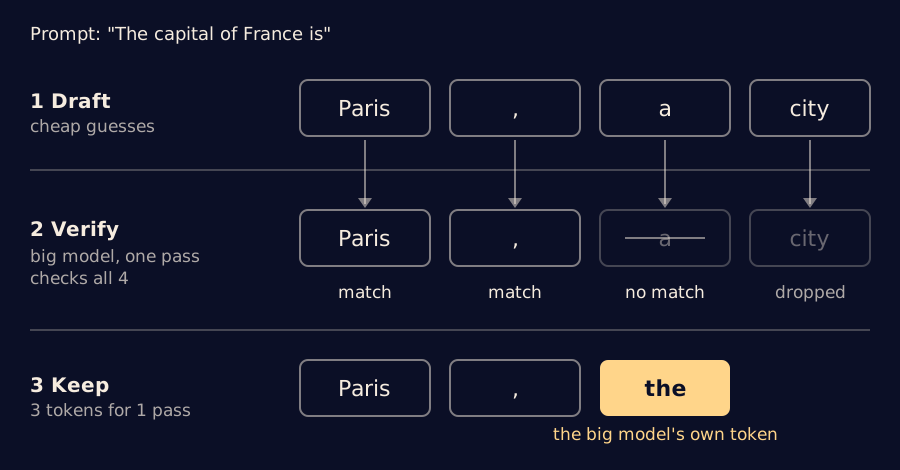
Los dos trucos son la misma idea, la decodificación especulativa. Un adivinador barato redacta unos cuantos tokens y el modelo grande los comprueba todos de una pasada. Se queda con las suposiciones que coinciden, sustituye la primera incorrecta por su propio token y descarta el resto. Las palabras del diagrama son un ejemplo inventado para mostrar el mecanismo, no una ejecución medida.
La carrera de abajo reproduce una respuesta de 400 tokens de cada modelo a las velocidades que medí, y un botón la reinicia. Qwen pasa 3,46 segundos leyendo el prompt antes de decir nada, y para entonces Ornith ya va por unos dos tercios de su respuesta.
El gráfico pone las dos mediciones una junto a otra. El primer par de barras es el que me importa.
Medí con aiperf 0.12.0, con un solo modelo cargado cada vez, el servidor reiniciado antes de cada ejecución y sin otro tráfico. Este es el comando. Funciona contra cualquier servidor compatible con OpenAI:
aiperf profile --url http://localhost:8010 --model <model-id> \
  --endpoint-type chat --streaming \
  --concurrency 1 --request-count 8 --num-warmup-requests 2 \
  --prompt-input-tokens-mean 800 --prompt-input-tokens-stddev 0 \
  --output-tokens-mean 400 --output-tokens-stddev 0 \
  --extra-inputs '{"temperature":0.6,"chat_template_kwargs":{"enable_thinking":false}}' \
  --tokenizer <model-snapshot-dir> --random-seed 7
Actualizar oMLX mejoró a Qwen en un 20 %, y no fue suficiente
Pasar de oMLX 0.6.4 a 0.7.0 subió Qwen3.8-27B de 57-59 a 71,7 tokens por segundo con un prompt de código y de 46-48 a 55-56 con prosa, con dos ejecuciones por celda y 400 tokens de salida. Las notas de la versión oMLX 0.7.0 mencionan una verificación y decodificación MTP más rápidas para este modelo, y los números lo confirman. Ornith se quedó donde estaba: 103-121 tokens por segundo en código, 99-102 en prosa.
También probé el ajuste obvio. MTP redacta hasta 4 tokens por ciclo por defecto en este modelo, y oMLX permite subir el límite. Con 6 la velocidad de salida fue de 53,9 tokens por segundo, con 8 fue de 52,4, frente a 55,1 con el valor por defecto. El controlador adaptativo ya elige una profundidad que compensa, así que dejé el ajuste como estaba.
En una prueba de revisión de código los dos modelos empatan
Con el razonamiento desactivado, Qwen3.8-27B detectó 9 de 20 fallos plantados y Ornith 1.5 detectó 8. Con 20 casos, un fallo de diferencia es ruido. La prueba toma 20 commits reales de cuatro de mis repositorios, cambia un operador en una línea añadida (< por <=, == por !=, un not eliminado) y pide al modelo que revise el diff en una sola llamada, sin herramientas. Cada caso va emparejado con el diff limpio, y un modelo solo puntúa si marca la línea plantada en el mutante y no en la versión limpia.
| Modelo | Razonamiento | Fallos detectados | Respuestas ilegibles | Hallazgos por diff limpio | Tiempo mediano |
|---|---|---|---|---|---|
| Qwen3.8-27B + MTP | off | 9 de 20 (45 %) | 4 de 40 | 0,7 | 10 s |
| Ornith 1.5 + DFlash | off | 8 de 20 (40 %) | 2 de 40 | 1,6 | 3 s |
| Qwen3.8-27B + MTP | on | 6 de 20 (30 %) | 12 de 40 | 0,3 | 194 s |
| Ornith 1.5 + DFlash | on | 8 de 20 (40 %) | 13 de 40 | 0,0 | 102 s |
Las filas de Ornith se midieron el 2 de octubre de 2026 con oMLX 0.6.4, las de Qwen el 12 de octubre con la 0.7.0. Con el razonamiento desactivado, donde difieren es en las falsas alarmas. Qwen reporta la mitad de problemas en código que no tiene ninguno, y tarda tres veces más por revisión.
Activar el razonamiento no ayuda a Qwen. Detectó 6 de 20 frente a 9 sin él, y la mitad de sus 40 respuestas agotaron el límite de salida de 12.000 tokens, por eso 12 de ellas nunca llegaron a ser JSON válido. Ornith piensa de más de la misma manera y pierde 13 de 40 respuestas, pero se mantiene en 8 de 20 y tarda más o menos la mitad por revisión. Una revisión que necesita tres minutos y falla al parsearse un tercio de las veces no me sirve con ninguno de los dos modelos.
Los dos modelos no caben juntos en memoria
Qwen3.8-27B ocupa 16,1 GB una vez cargado y Ornith 1.5 ocupa 19,8 GB. En una máquina de 64 GB suena bien, y con oMLX 0.6.4 los dos se cargaron, con el swap subiendo a 15,3 de 16 GB. El control de memoria de la 0.7.0 se niega en cambio. Mientras Qwen estaba ocupado, cada petición a Ornith recibió esto:
POST /v1/responses → 507: Cannot load Ornith-1.5-35B-A3B-MLX-4bit: projected memory
38.24GB would exceed the dynamic memory ceiling 34.51GB
Cuando Qwen está inactivo, oMLX expulsa un modelo para cargar el otro, y el log marca la descarga como un aborto inmediato, así que una petición en curso en el modelo expulsado se pierde. Descubrí cómo se ve eso bajo carga por accidente. Ejecuté la prueba de revisión en Qwen con el razonamiento activado durante 90 minutos mientras otra herramienta seguía enviando peticiones a Ornith. oMLX cargó Ornith, lo expulsó seis segundos después para hacer sitio al prompt de Qwen, lo cargó otra vez y acabó expulsando a Qwen en mitad de una respuesta. De las 40 peticiones de Qwen, 19 fallaron.
Esperaba mantener a Qwen junto a Ornith como segunda opinión, y eso queda descartado. Tengo que elegir uno, y con estos números elijo Ornith.
Qwen a veces corta su propio JSON, y el arreglo cuesta la mitad de la velocidad
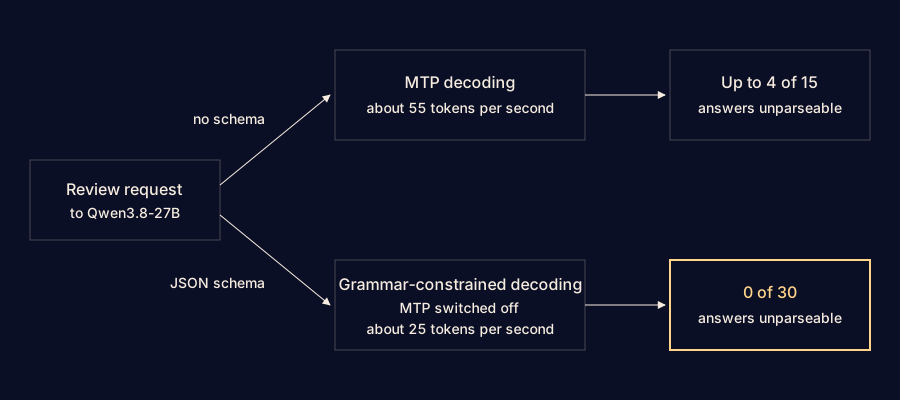
En 5 de 40 respuestas de revisión, Qwen3.8-27B devolvió {"findings":[] y se detuvo, sin la llave de cierre. Solo ocurrió en respuestas vacías de cinco o seis tokens. Repetí los cinco diffs afectados tres veces cada uno con cuatro configuraciones, con MTP activado y desactivado y con la penalización de presencia a 1,5 y a 0. Las respuestas cortadas aparecieron también con MTP desactivado, y sin la penalización, en hasta 4 de 15 ejecuciones. Por lo que puedo ver, el modelo simplemente termina antes de tiempo de vez en cuando.
La decodificación restringida lo elimina. oMLX la trae integrada mediante xgrammar, pero la fórmula de Homebrew la deja fuera salvo que lo pidas:
brew reinstall jundot/omlx/omlx --with-grammarCon un esquema JSON en la petición, 0 de 30 respuestas fueron ilegibles. El diagrama muestra lo que cuesta. Una gramática y MTP no pueden funcionar a la vez, así que esas peticiones recurren a la decodificación normal, a unos 25 tokens por segundo.
Lo que sigue abierto
La fila de Qwen con razonamiento activado mezcla dos ejecuciones. 21 respuestas vienen de la ejecución de la mañana descrita arriba, con otro tráfico en el servidor, y repetí las 19 peticiones fallidas por la tarde con todo lo demás en pausa. Conté las respuestas de la mañana porque estaban completas, y no volví a ejecutar las 40 en una sola pasada limpia. La prueba de velocidad usó 8 peticiones y un solo tamaño de prompt. No probé la visión de Qwen, y no sé qué le cuesta un esquema JSON a Ornith con DFlash.
Quité Qwen del proxy esa misma tarde y borré sus pesos, así que nada de eso se va a medir. El siguiente candidato es Muse Glimmer 30B, que estoy midiendo ahora.
Para el trabajo interactivo, donde esperas cada respuesta, Ornith se queda. Si estás eligiendo un modelo local para un Mac, mide el tiempo hasta el primer token con la longitud de prompt que de verdad envías antes de mirar los tokens por segundo. Para trabajos desatendidos esa diferencia importa mucho menos.
Seguir leyendo
Cómo medir la visibilidad de marca en respuestas de IA
Caso de estudio del stack de datos de una correduría de seguros. Medir cuota de voz contando nombres o dominios citados revela lo que un conteo de nombres esconde.
OmniZenit: el depurador de analítica que nadie me pidió construir
Caso de producto de una extensión de Chrome que empecé por mi cuenta para revisar eventos de analítica de una marca de Inditex, y cómo acabó siendo el depurador que usa todo el grupo.